چگونه مدلهای هوش مصنوعی را بهصورت محلی اجرا کنیم و چرا این کار میتواند ارزشمند باشد
مدلهای هوش مصنوعی دارای وزنباز اکنون بهطور میانگین تنها حدود چهار ماه از قدرتمندترین مدلهای بسته عقب هستند و شمار بیشتری از آنها را میتوان روی رایانههایی اجرا کرد که احتمالاً کاربران از قبل در اختیار دارند.
اصطلاح «وزنباز» به مدلهایی اشاره دارد که توسعهدهندگانشان وزنهای آنها ــ فایلهایی که آموختههای مدل در فرایند آموزش را در خود نگه میدارند ــ منتشر میکنند تا هر کسی بتواند آنها را دانلود و اجرا کند. دو نرمافزار رایگان Ollama و LM Studio سایر مراحل را بر عهده میگیرند. حجم نسخههای Gemma 4 موجود در کتابخانه Ollama از حدود ۴.۶ گیگابایت تا ۲۰ گیگابایت متغیر است.
با استفاده از مدلهای باز، برای دسترسی به یک چتبات توانمند نیازی نیست ماهانه ۲۰ دلار بابت اشتراک هوش مصنوعی بپردازید یا مکالمات خود را به سرورهای شرکت دیگری بفرستید. این راهنما توضیح میدهد چگونه مدلهای هوش مصنوعی را مستقیماً روی رایانه خود دانلود و اجرا کنید، به چه سختافزاری نیاز دارید و چگونه کار با ابزارهای رایگانی مانند Ollama و LM Studio را آغاز کنید.
چه هدف شما کاهش هزینهها باشد، چه حفظ محرمانگی مکالمات یا آزمایش مدلهایی که میتوانید شخصاً سفارشیسازی کنید، راهاندازی یک دستیار هوش مصنوعی محلی ممکن است سادهتر از چیزی باشد که تصور میکنید.
چرا یک مدل هوش مصنوعی را روی رایانه خود اجرا کنیم؟
یک چتبات مبتنی بر فضای ابری، هر درخواست را به سرورهای شرکت ارائهدهنده ارسال میکند. همانطور که Decrypt در بررسی ابزارهای هوش مصنوعی متمرکز بر حریم خصوصی گزارش داده است، دادگاهی OpenAI را ملزم کرد گزارشهای ChatGPT، از جمله موارد حذفشده، را حفظ کند. در مقابل، هنگام استفاده از یک مدل محلی، مکالمه روی رایانه شما باقی میماند و هیچکس بدون اجازه شما نمیتواند به آن دسترسی داشته باشد.
طبق مستندات LM Studio، این برنامه «میتواند کاملاً آفلاین کار کند؛ فقط کافی است ابتدا فایلهای مدل را دریافت کنید». اسنادی که به یک گفتوگو پیوست میشوند نیز میتوانند بهطور کامل بهصورت آفلاین پردازش شوند.
هزینه اشتراک چتباتهای پولی معمولاً حدود ۲۰ دلار در ماه است، در حالی که نرمافزارهای معرفیشده در این راهنما رایگان هستند. بنابراین هزینه اصلی به سختافزاری مربوط میشود که ممکن است از قبل در اختیار داشته باشید.
مجوز هر مجموعه وزن دانلودشده تعیین میکند که چه نوع استفادهای از آن مجاز است. مجموعه R1 شرکت DeepSeek تحت مجوز MIT منتشر شده است. در کارت مدل این مجموعه آمده که مدلها «از استفاده تجاری پشتیبانی میکنند و امکان هرگونه تغییر و ساخت آثار مشتقشده را فراهم میآورند». در همین حال، Gemma 4 شرکت Google و gpt-oss شرکت OpenAI تحت مجوز Apache 2.0 عرضه شدهاند.
اجرای مدلهایی که تحت مجوزهای متنبازی مانند Apache یا MIT منتشر میشوند، به کاربران آزادی استفاده و تغییر آنها را میدهد و امکان بهرهگیری از آنها را در چارچوب مفاد همان مجوزها فراهم میکند. همچنین نسخههای بهبودیافته یا تغییریافته یک مدل در دسترس افرادی قرار میگیرد که نیازهایشان با کاربرد اولیه آن متفاوت است. برای مثال، ممکن است کاربری به مدلی مناسب فعالیتهای پزشکی نیاز داشته باشد و در مقابل، توانایی مدل در برنامهنویسی برای او اهمیتی نداشته باشد. چنین سطحی از تطبیقپذیری با استفاده از مدلهای سفارشیسازیشده امکانپذیر است.
سختافزار شما واقعاً چه مدلهایی را میتواند اجرا کند؟
اندازه مدلها با تعداد پارامترهای آنها سنجیده میشود؛ پارامترها مقادیر داخلیای هستند که در جریان آموزش تنظیم میشوند و معمولاً هرچه تعدادشان بیشتر باشد، حجم فایل دانلودی نیز افزایش مییابد. برای اجرای مدل، فایلهای آن باید در حافظه گرافیکی رایانه، موسوم به حافظه ویدئویی (VRAM)، یا در مک در حافظه یکپارچهای جا بگیرند که پردازنده و تراشه گرافیکی بهطور مشترک از آن استفاده میکنند.
بهعنوان یک قاعده کلی، دستکم ۸ گیگابایت VRAM مطلوب است؛ مدلهای کوچکتر و فشردهشده میتوانند در همین ظرفیت جا بگیرند. با این حال، کاربران حرفهایتر بهتر است یک پردازنده گرافیکی مخصوص بازی با دستکم ۲۴ گیگابایت VRAM تهیه کنند. این ظرفیت را میتوان با کنار هم قرار دادن چند GPU فراهم کرد یا از طریق رکهای اختصاصی هوش مصنوعی و دستگاههایی با حافظه یکپارچه، مانند Mac Mini یا Nvidia DGX Spark، در اختیار داشت.
کوانتیزهسازی (Quantization) با ذخیرهکردن هر وزن در قالب بیتهای کمتر، حجم مدل را کاهش میدهد. مستندات Hugging Face این فرایند را نمایش وزنها و فعالسازیها با «انواع داده کمدقت، مانند عدد صحیح ۸ بیتی (int8)، بهجای قالب معمول ممیز شناور ۳۲ بیتی (float32)» توصیف میکند. این روش مصرف حافظه را کاهش میدهد، اما بخشی از دقت مدل را نیز تحت تأثیر قرار میدهد.
در الزامات سیستمی LM Studio توصیه شده است مکهای مجهز به Apple Silicon که macOS 14 یا نسخههای جدیدتر را اجرا میکنند، دستکم ۱۶ گیگابایت RAM داشته باشند؛ هرچند مکهای دارای ۸ گیگابایت نیز از پس اجرای مدلهای کوچکتر برمیآیند. برای رایانههای ویندوزی، حداقل ۱۶ گیگابایت RAM و ۴ گیگابایت VRAM اختصاصی، بههمراه پردازنده دارای پشتیبانی از AVX2 توصیه شده است. مکهای مبتنی بر پردازندههای Intel پشتیبانی نمیشوند.
در کتابخانه Ollama، حجم Gemma 4 26B بین ۱۶ تا ۱۹ گیگابایت و حجم نسخه 31B بین ۱۹ تا ۲۰ گیگابایت اعلام شده است. به گفته OpenAI، مدل gpt-oss-20b تنها به ۱۶ گیگابایت حافظه نیاز دارد و gpt-oss-120b در محدوده ۸۰ گیگابایت اجرا میشود.
چگونه Ollama و LM Studio را راهاندازی کنیم؟
LM Studio احتمالاً برای بسیاری از کاربران گزینه مناسبتری است، زیرا رابط گرافیکی کاربرپسند و پرداختشدهای ارائه میکند. در مقابل، Ollama بیشتر برای توسعهدهندگان و کاربران باتجربهای طراحی شده است که ترجیح میدهند با رابط خط فرمان (CLI) کار کنند.
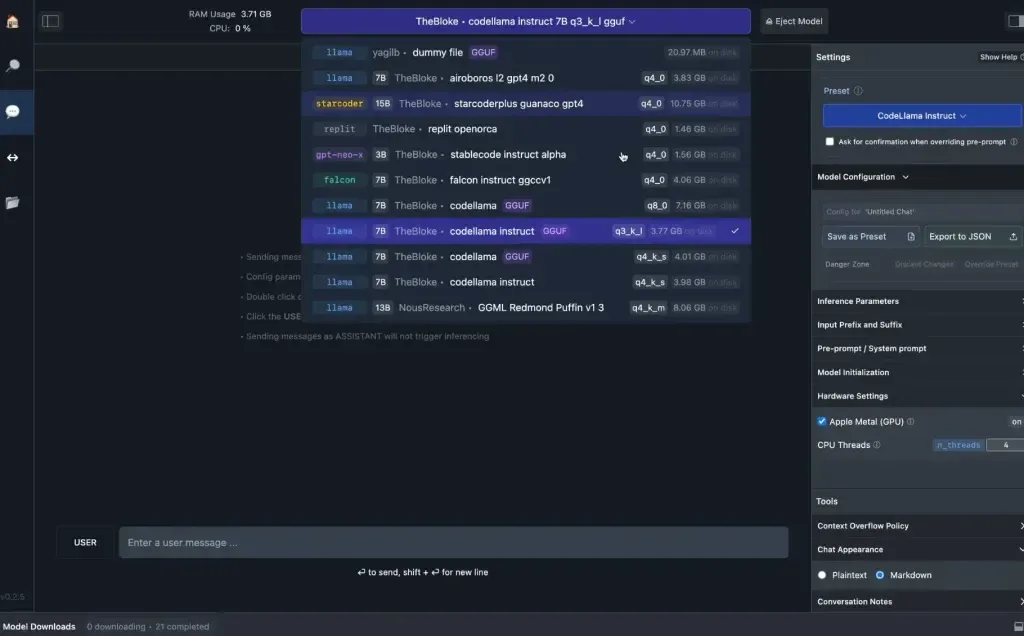
برای شروع کار با LM Studio، فایل نصب متناسب با سیستمعامل خود را از وبسایت lmstudio.ai دانلود کنید. سپس درون برنامه به جستوجوی یک مدل بپردازید، وزنهای آن را دانلود کنید و یک گفتوگو را آغاز کنید. این برنامه در Hugging Face جستوجو میکند؛ مرکزی عمومی که مدلهای باز در آن منتشر میشوند.
کاربران macOS و Linux میتوانند Ollama را با اجرای دستور curl -fsSL https://ollama.com/install.sh | sh نصب کنند. کاربران Windows نیز باید دستور irm https://ollama.com/install.ps1 | iex را در PowerShell اجرا کنند. هر دو دستور در صفحه دانلود Ollama ارائه شدهاند.
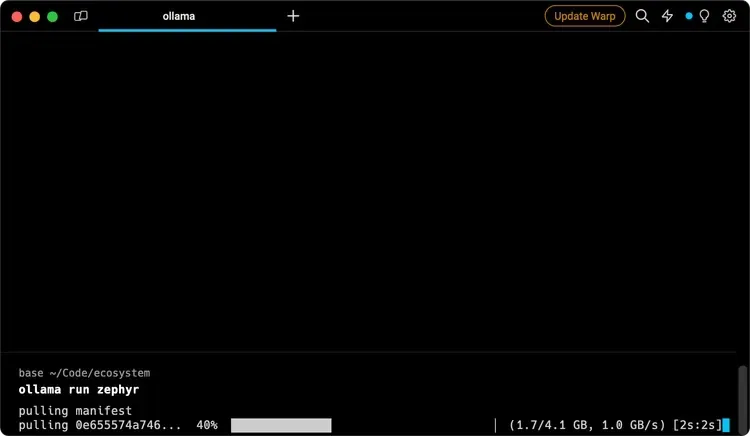
با واردکردن دستور ollama pull gemma4:e2b، مدل دانلود میشود و دستور ollama run gemma4:e2b یک گفتوگو را باز میکند. بر اساس راهنمای شروع سریع Ollama، دستور /bye برای خروج از گفتوگو به کار میرود. این برنامه همچنین یک API محلی در نشانی http://localhost:11434 راهاندازی میکند تا سایر برنامههای موجود روی همان رایانه نیز بتوانند از مدل استفاده کنند.
مدلهایی که نامشان به «:cloud» ختم میشود، مانند gemma4:cloud، متفاوت هستند: این مدلها در فضای ابری Ollama اجرا میشوند و نیازی به دانلود ندارند. بنابراین اگر هدف از اجرای مدل محلی حفظ حریم خصوصی است، باید از نسخههای ابری صرفنظر کرد. با این حال، این نسخهها برای کسانی که به مدلهای قدرتمندتری نیاز دارند، گزینه دومی به شمار میروند: درخواستهای API و ورودیهایی که از این طریق پردازش میشوند، در سرورهای ارائهدهندگان ذخیره نمیشوند و برای آموزش مدلها نیز به کار نمیروند.
پیشنویسسازهای Multi-Token Prediction شرکت Google برای Gemma 4 که از طریق Ollama و تحت مجوز Apache 2.0 در دسترساند، میتوانند سرعت تولید خروجی را تا سه برابر افزایش دهند. این قابلیت از رمزگشایی حدسی (Speculative Decoding) استفاده میکند؛ روشی که در آن یک مدل کوچکتر چند توکن بعدی را پیشنهاد میدهد و مدل بزرگتر آنها را بهصورت یکجا بررسی میکند.
Google توضیح داده است: «اگر مدل هدف با پیشنویس موافق باشد، کل توالی را در یک گذر رو به جلو میپذیرد.» مدل هدف در همان گذر، یک توکن اضافی را نیز خودش تولید میکند.
مدلهای محلی میتوانند از طریق سرورهای MCP به قابلیت جستوجوی وب و دسترسی به فایلها مجهز شوند. MCP مخفف Model Context Protocol است و طبق راهنمای Decrypt، LM Studio در نسخه 0.3.17 پشتیبانی از آن را اضافه کرده است.
مدلهای محلی در چه زمینههایی هنوز از مدلهای ابری عقب هستند؟
میانگین فاصله چهارماهه به پیشرفتهترین مدلهای باز مربوط میشود؛ بزرگترین مدلها همچنان بسیار فراتر از توان سختافزارهای مصرفی قرار دارند. Qwen3.8-Max شرکت Alibaba در مجموع ۲.۴ تریلیون پارامتر دارد که در هر لحظه ۹۵ میلیارد پارامتر آن فعال است. در مقایسه، به گفته OpenAI، مدل gpt-oss-120b در محدوده ۸۰ گیگابایت حافظه اجرا میشود.
وقتی یک مدل از ظرفیت VRAM فراتر میرود و بخشی از دادههای آن به RAM سیستم منتقل میشود، ممکن است سرعت پاسخگویی بهشدت کاهش یابد. پنجرههای متنی بزرگتر نیز به حافظه بیشتری نیاز دارند. پنجره متنی به حجمی از متن گفته میشود که مدل میتواند در یک زمان در نظر بگیرد. مدلهای کوچکتر Gemma 4 پنجره متنی ۱۲۸ هزار توکنی دارند و این مقدار در نسخههای بزرگتر به ۲۵۶ هزار توکن میرسد.
سرویسهای ابری نیاز به برنامهریزی برای این محدودیتهای سختافزاری را از میان میبرند و مدلهای پیشرو که پشتوانه این سرویسها هستند، همچنان در دشوارترین آزمونها عملکرد بهتری دارند.
برای افرادی که میخواهند از هوش مصنوعی بهصورت خصوصی استفاده کنند، بررسی خود Decrypt ابزار «xPrivo همراه با یک مدل محلی خودمیزبان را برای نگارش روزمرهای که نباید از دستگاه شما خارج شود» و Kagi را «زمانی که به بازیابی اطلاعات از وب نیاز دارید و با مصالحه مربوط به فراخوانی API موافق هستید» توصیه کرده است.